DevOps Mind
Zabbix poller processes busy 75%: como eu diagnostico e ajusto

O alerta “Zabbix poller processes more than 75% busy” (ou o irmão dele, “Zabbix unreachable poller processes more than 75% busy”; nos templates mais novos, “Zabbix server: Utilization of poller processes over 75%”) costuma aparecer depois de eventos em que diversos nodes nascem, morrem ou trocam de lugar. Em um ambiente misto, com clusters Kubernetes na AWS EKS, EC2, VMs e ainda Web Scenarios, a carga sobre os pollers explode rápido se os processos não estiverem dimensionados para aquela rajada.
Quando vi isso pela primeira vez, o sintoma parecia simples: pollers saturados. A tentação foi ir no zabbix_server.conf e aumentar os números, e o meu tuning inicial saiu com valores que não estavam acertados para o ambiente. Ajustar sem entender a causa não resolve.
Hoje, quando o alerta dispara, eu sigo três passos antes de tocar em qualquer parâmetro.
Raciocínio em 3 passos
1. Tem algum evento anormal acontecendo?
Poller não fica ocupado sozinho. O gatilho comum é um evento de infraestrutura:
- escalação horizontal de nodes (auto scaling group ativado)
- rollout de Deployment ou DaemonSet em vários nodes ao mesmo tempo
- falha de node e reagendamento de carga
- rede instável deixando hosts oscilando entre reachable e unreachable
Eu começo pelos dashboards de infraestrutura e pelos eventos do Kubernetes. Se o número de itens por segundo ou de hosts unreachable subiu na mesma janela do alerta, a causa provavelmente não é falta de poller. É o evento que precisa de atenção. Nesses casos, aumentar pollers é apenas alívio de sintoma.
2. Algum Zabbix proxy está onerando?
Quando o ambiente tem proxies distribuídos, um proxy mal dimensionado pode jogar a fila toda para o server. Eu verifico:
- qual proxy está com queue alta
- se o proxy roda como container no Kubernetes com limites de CPU/memória apertados
- se o proxy perdeu conectividade com o server e acumulou valores
3. Tem configuração aplicada incorretamente?
O último passo é conferir se os ajustes realmente foram aplicados. O arquivo editado é o que o serviço lê? No proxy em container, a variável de ambiente chegou ao arquivo de configuração?
A ordem importa. Resolver o evento primeiro, depois dimensionar, depois validar.
Onde ajustar: server e proxy
Quando o diagnóstico aponta que realmente preciso de mais pollers, eu mexo em dois lugares.
Zabbix 7.0 ou mais novo Os valores deste post foram aplicados no Zabbix 6.4. A partir do Zabbix 7.0, checks de agente, HTTP agent e SNMP passaram para pollers assíncronos, com parâmetros próprios: StartAgentPollers, StartHTTPAgentPollers e StartSNMPPollers. No 7.x, descubra primeiro qual tipo de poller está saturado antes de mexer em StartPollers.
Zabbix Server
No servidor, os parâmetros estão no zabbix_server.conf:
fernando@zabbix-server:/etc/zabbix# cat zabbix_server.conf | grep StartPollers
### Option: StartPollers
StartPollers=25
### Option: StartPollersUnreachable
StartPollersUnreachable=10
Depois de editar:
systemctl restart zabbix-serverValores não são universalmente copiáveis Não copie 25 e 10 achando que vão funcionar no seu ambiente. O número ideal depende de quantos itens você coleta, quantos hosts são unreachable e quanta CPU/memória o server tem sobrando. Use isso como ponto de partida e meça.
Zabbix Proxy no Kubernetes
Quando o proxy roda como Deployment no Kubernetes, eu uso variáveis de ambiente que o container do Zabbix já entende. A lista completa pode ser consultada no repositório de referência do Zabbix Docker, mas no dia a dia eu só preciso de duas:
ZBX_STARTPOLLERSZBX_STARTPOLLERSUNREACHABLE
Aqui está um trecho do Deployment que eu ajustei. Antes:
spec:
  containers:
    - env:
        - name: ZBX_HOSTNAME
          value: zabbix-proxy-lab
        - name: ZBX_SERVER_HOST
          value: zabbix-server
        - name: ZBX_CACHESIZE
          value: 256M
        - name: ZBX_CONFIGFREQUENCY
          value: '60'
Depois:
spec:
  containers:
    - env:
        - name: ZBX_HOSTNAME
          value: zabbix-proxy-lab
        - name: ZBX_SERVER_HOST
          value: zabbix-server
        - name: ZBX_CACHESIZE
          value: 256M
        - name: ZBX_CONFIGFREQUENCY
          value: '60'
        - name: ZBX_STARTPOLLERS
          value: '25'
        - name: ZBX_STARTPOLLERSUNREACHABLE
          value: '10'
Reinicie o pod e valide dentro do container:
bash-5.1$ cd /etc/zabbix/
bash-5.1$ cat zabbix_proxy.conf | grep StartPollers
### Option: StartPollers
# StartPollers=5
StartPollers=25
### Option: StartPollersUnreachable
# StartPollersUnreachable=1
StartPollersUnreachable=10
Valide no arquivo, não só no YAML O Kubernetes pode ter aplicado a variável, mas se o entrypoint do container não a injetou no zabbix_proxy.conf, o valor real continua o antigo. Sempre entro no container e confiro o arquivo.
Evidências depois do ajuste
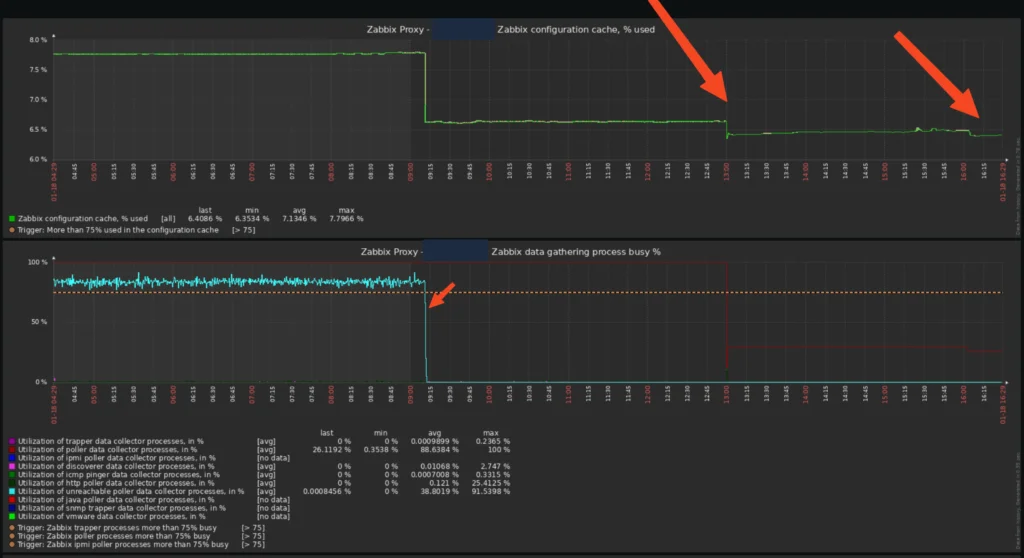
Depois do ajuste, estes são os painéis do Zabbix que usei para verificar o resultado. No proxy, a utilização dos pollers caiu de 100% para cerca de 25%, e a fila saiu de picos de 920 itens para perto de zero.
| Gráfico | O que conferir |
|---|---|
| Utilização dos pollers | se saiu da faixa de saturação (o alerta dispara acima de 75%) |
| Unreachable pollers | se voltou a um patamar baixo |
| Configuration cache e data gathering process | se estabilizou, sem picos recorrentes |
| Proxy: valores processados por segundo e fila | se a fila zerou |




Zabbix + Kubernetes
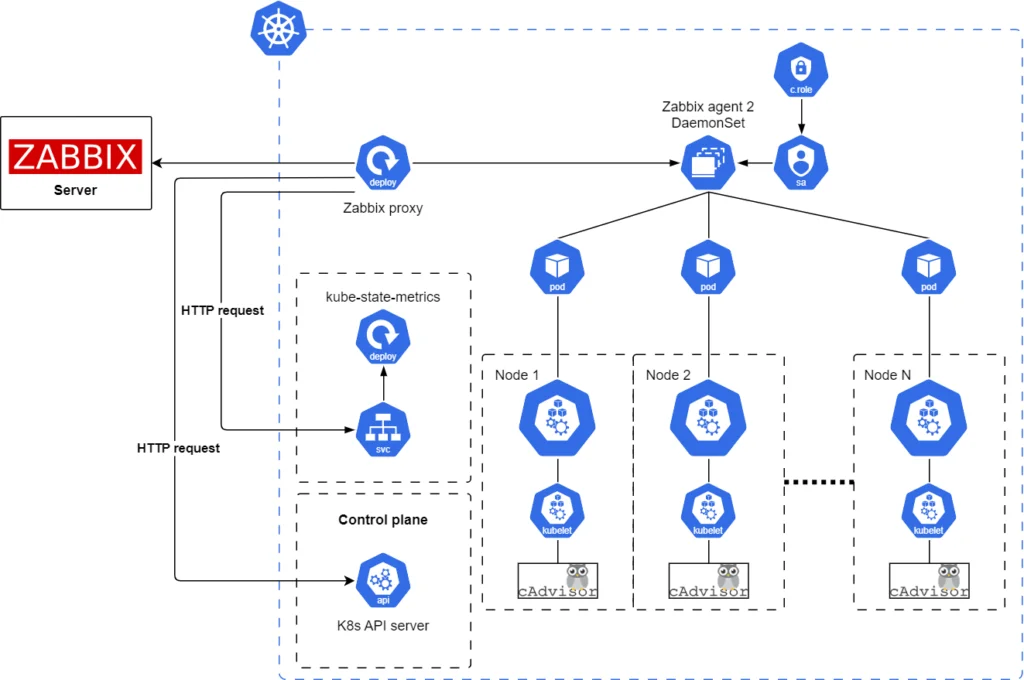
Nos meus clusters EKS, o Zabbix me deu insumos e me alertou com antecedência sobre problemas em diversos cenários. Para quem quer montar essa integração, o caminho oficial é o Helm chart do Zabbix para Kubernetes, linkado nos recursos abaixo. Vale a leitura antes de tentar inventar a arquitetura.
Conclusão
O alerta de poller busy não é apenas falta de processo. Na maioria das vezes, ele é sintoma de algo maior: um evento de infraestrutura, um proxy onerado ou uma configuração que não foi aplicada onde deveria.
Minha leitura: aumentar StartPollers e StartPollersUnreachable funciona, mas só depois de eliminar as causas anteriores. Do contrário, você vai viver tunando número e nunca vai entender por que o alerta volta.
Para continuar em observabilidade, veja também de onde vêm as métricas no Kubernetes: cAdvisor, kubelet e CRI e como configurar NTP no Linux com Chrony.
Recursos adicionais
- Documentação Oficial do Zabbix: https://www.zabbix.com/documentation/current/
- Modelo de Monitoramento de Kubernetes do Zabbix: https://www.zabbix.com/integrations/kubernetes e https://www.zabbix.com/integrations/kubernetes#kubernetes_http
- Monitoramento de Contêineres com Zabbix: https://www.zabbix.com/br/container_monitoring
- Blog post sobre uso de Zabbix com Kubernetes: https://blog.zabbix.com/monitoring-kubernetes-with-zabbix/25055/
- Repositório do Helm para provisionamento no Kubernetes: https://git.zabbix.com/projects/ZT/repos/kubernetes-helm/browse